En la cultura popular de la informática, existe un mantra peligroso y profundamente arraigado: «Si funciona, no lo toques». Esta mentalidad reactiva —esperar a que algo se rompa para intentar arreglarlo— puede ser aceptable cuando hablamos del ordenador que usas para ver series el fin de semana. Sin embargo, cuando administras el servidor de una empresa, una base de datos con información de clientes o tu propia estación de trabajo de la que depende tu sueldo, esta filosofía es una garantía absoluta de desastre.
El software falla por errores de lógica, pero el hardware falla por las implacables leyes de la física. El polvo se acumula bloqueando los flujos de aire, la pasta térmica de los procesadores se reseca y se vuelve yeso, y las celdas de memoria flash de los discos de estado sólido (SSD) sufren desgaste físico con cada operación de escritura.
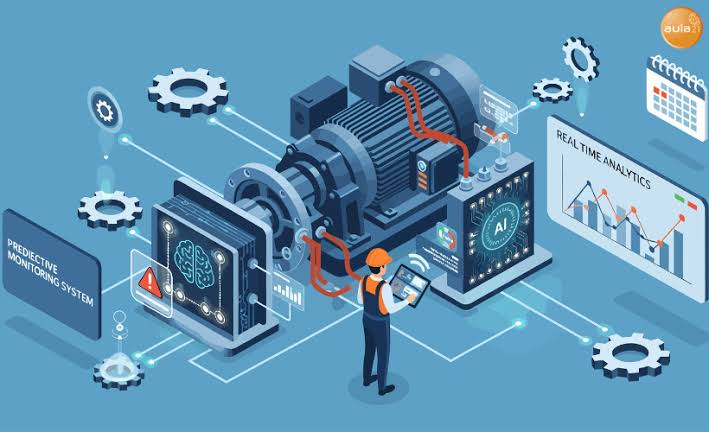
El verdadero trabajo de un ingeniero de sistemas o desarrollador Full-Stack no es apagar incendios a las tres de la madrugada, sino establecer sistemas de vigilancia que detecten el humo días antes de que haya fuego. En este artículo, exploraremos las herramientas y estrategias fundamentales de monitorización y mantenimiento preventivo, aprendiendo a «escuchar» el hardware antes de que colapse de forma irreversible.
1. El Enemigo Silencioso: La Temperatura y el Thermal Throttling
De todos los factores que degradan el hardware, el calor es el destructor número uno. Los componentes electrónicos modernos son maravillas de la miniaturización, metiendo miles de millones de transistores en un chip del tamaño de un sello. Cuando la electricidad atraviesa esos transistores, se genera calor residual. Si ese calor no se disipa adecuadamente a través de los ventiladores y disipadores, la temperatura se dispara en cuestión de segundos.
¿Qué ocurre cuando un procesador (CPU) o una tarjeta gráfica (GPU) alcanza los 90°C o 100°C? A diferencia de los ordenadores de los años 90, que literalmente empezaban a arder, los procesadores modernos cuentan con un mecanismo de autodefensa llamado Thermal Throttling (Estrangulamiento Térmico).
Cuando el sensor de la CPU detecta una temperatura crítica, el chip reduce drásticamente su propia velocidad de reloj y su voltaje para generar menos calor y evitar derretirse. Como resultado, tu servidor o tu portátil, que tiene un procesador potentísimo, pasa a funcionar a la velocidad de un ordenador de hace diez años. Esa lentitud repentina al compilar código o exportar un vídeo casi nunca es un fallo del software; es tu hardware intentando sobrevivir.
Cómo Monitorizar la Temperatura como un Profesional
Para evitar el Thermal Throttling, debes vigilar las temperaturas.
- En entornos Windows: Existen herramientas gratuitas y ligeras como HWMonitor o Core Temp. Al dejarlas abiertas en segundo plano, te mostrarán la temperatura actual, mínima y máxima de cada núcleo del procesador. Un procesador en reposo (idle) debería rondar los 35°C – 45°C. Bajo carga extrema (compilando código complejo), no debería superar los 80°C – 85°C.
- En entornos Linux (Ubuntu/Servidores): En la terminal, no tenemos interfaces gráficas, pero contamos con una herramienta magistral llamada
lm-sensors.
Para instalarla y configurarla en tu máquina virtual o servidor Ubuntu, solo debes ejecutar:
Bash
# Instalamos el paquete de sensores
sudo apt install lm-sensors

# Permitimos que el programa escanee nuestra placa base en busca de sensores físicos
sudo sensors-detect --auto

# A partir de ahora, con escribir 'sensors', obtendremos un reporte instantáneo:
sensors
(Nota: En máquinas virtuales como VirtualBox, a menudo no verás sensores reales porque el hipervisor oculta el hardware físico, pero en un servidor «Bare Metal» de producción o instalándolo directamente en tu equipo local, verás las temperaturas exactas al milígrado).
2. La Salud del Almacenamiento: El Protocolo S.M.A.R.T. al Rescate
El segundo punto crítico de fallo en cualquier sistema informático es el disco de almacenamiento. Perder una memoria RAM o un ventilador es un problema de dinero (compras otro y sigues trabajando); perder un disco duro es un problema catastrófico, porque pierdes la información (tu código, tus bases de datos, los registros de tus clientes).
Lo que mucha gente desconoce es que los discos duros mecánicos (HDD) y los de estado sólido (SSD) no mueren de un día para otro sin avisar. Todos los discos modernos incluyen un sistema de autodiagnóstico integrado en su propio firmware llamado S.M.A.R.T. (Self-Monitoring, Analysis, and Reporting Technology).
El disco duro lleva un «diario secreto» de su propia degradación. Registra cuántas horas lleva encendido, cuántas veces ha fallado al intentar escribir en un sector, si ha sufrido golpes físicos e, importantísimo para los SSD, cuántos Terabytes Written (TBW) ha consumido (ya que los SSD tienen una vida útil finita de escrituras).
Monitorizando S.M.A.R.T. en la Terminal
Para leer este diario secreto en Linux y predecir cuándo va a morir tu disco duro, utilizamos la suite smartmontools.
Bash
# Instalamos la herramienta
sudo apt install smartmontools

# Primero, listamos nuestros discos (usualmente serán /dev/sda o /dev/nvme0n1)
lsblk

# Ahora le pedimos a smartctl que lea el historial médico del disco
sudo smartctl -a /dev/sda
La salida de este comando te mostrará una tabla con decenas de atributos. Si ves que el valor de Reallocated_Sector_Ct (Sectores reasignados porque los originales han muerto) empieza a subir mes a mes, es el disco duro gritándote: «Voy a fallar de forma inminente, por favor, saca una copia de seguridad y cámbiame». En Windows, este mismo chequeo se realiza de forma visual utilizando la herramienta gratuita CrystalDiskInfo.
3. Monitorización Avanzada: De la Terminal a la Telemetría
Herramientas como htop (para ver el uso de CPU/RAM en tiempo real) y sensors están muy bien cuando estás físicamente sentado frente al ordenador. Pero, ¿qué ocurre si administras un servidor que está en un centro de datos en Alemania y tú estás durmiendo en España? No puedes estar mirando la terminal las 24 horas del día.
La industria resuelve esto evolucionando de la simple «observación» a la Telemetría y Monitorización Continua.
En arquitecturas corporativas, se instalan «Agentes» de monitorización en los servidores. El stack (conjunto de tecnologías) más popular del mundo actualmente es la combinación de Prometheus y Grafana.
- Prometheus es un software que se instala en el servidor y su única misión es recopilar métricas cada 5 segundos (¿A qué porcentaje está la CPU? ¿Cuánta RAM queda libre? ¿Cuántas peticiones web están entrando?). Almacena toda esta información en una base de datos temporal.
- Grafana es un panel de control web. Se conecta a Prometheus y dibuja gráficos espectaculares y fáciles de leer en el navegador.
El poder real de estos sistemas es la creación de Alertas. Puedes programar a Grafana para que evalúe las reglas y diga: «Si el espacio libre en el disco duro del servidor de base de datos cae por debajo del 15%, y la temperatura de la CPU supera los 85°C durante más de tres minutos seguidos, envíame un mensaje automático a Telegram o a Slack».
De esta forma, la infraestructura informática te avisa de sus dolores crónicos semanas antes de que se conviertan en fallos críticos, permitiéndote programar una ventana de mantenimiento un martes por la tarde en lugar de sufrir una caída no planificada un viernes por la noche.
4. Mantenimiento Preventivo Lógico en Sistemas Linux
El mantenimiento preventivo no solo aplica al polvo de los disipadores o a la vida útil de los discos; el software del sistema operativo también requiere una «limpieza de tuberías» periódica para evitar que el servidor acabe asfixiado por su propia basura digital.
Como administrador de sistemas, debes integrar estas rutinas en tus automatizaciones (usando cron y Shell Scripting, como vimos en capítulos anteriores):
A) La gestión de los Archivos de Registro (Logs)
Los servidores Linux registran absolutamente todo lo que hacen en la carpeta /var/log/. Si tu servidor web Apache o Nginx recibe millones de visitas, sus archivos de registro pueden crecer gigabytes enteros por día, llenando el disco SSD hasta el 100% y bloqueando el sistema. La solución es asegurarse de que el servicio Logrotate está bien configurado. Este programa automático coge los logs de hoy, los comprime en un archivo .gz, y borra automáticamente los logs que tengan más de 30 días de antigüedad, manteniendo el consumo de disco siempre estable y predecible.
B) Limpieza de Paquetes Huérfanos y Kernels Antiguos
Cada vez que Ubuntu se actualiza e instala un nuevo núcleo (Kernel), no borra el anterior por motivos de seguridad (por si el nuevo falla). Si dejas un servidor funcionando durante años, acumularás decenas de Kernels antiguos que consumen espacio crítico en la pequeña partición de arranque (/boot). Debes acostumbrarte a ejecutar comandos de limpieza profunda tras las actualizaciones:
Bash
# Limpia el caché de paquetes descargados que ya han sido instalados
sudo apt-get clean

# Elimina librerías y dependencias que se instalaron para programas que ya has borrado
sudo apt-get autoremove --purge
Conclusión
El hardware informático, por muy caro o avanzado que sea, es inherentemente falible. Los ventiladores acumulan polvo, la pasta térmica pierde su capacidad de transferencia de calor y el silicio de los discos duros se desgasta inexorablemente. Ignorar esta realidad física es el error más costoso que puede cometer un profesional de la tecnología.
El mantenimiento preventivo y la monitorización transforman la administración de sistemas de un juego de azar en una ciencia predecible. Al dominar el análisis de temperaturas para evitar el Thermal Throttling, aprender a auditar el historial de salud de los discos mediante S.M.A.R.T. y mantener los sistemas de archivos lógicos limpios y depurados, estás construyendo la resiliencia de tu infraestructura. Un buen administrador de sistemas rara vez se encuentra corriendo en pánico para revivir un servidor caído; un buen administrador observa una gráfica con una suave tendencia al alza un martes, pide las piezas de repuesto necesarias, y sustituye el hardware defectuoso un jueves, sin que un solo usuario del sistema haya notado el menor problema en el servicio.