Introducción
La inteligencia artificial (IA) está transformando numerosos sectores, desde la sanidad y la educación hasta las finanzas y la selección de personal. Los sistemas capaces de analizar grandes cantidades de datos y generar predicciones permiten automatizar tareas, mejorar procesos y apoyar la toma de decisiones.
Sin embargo, estas tecnologías también plantean importantes desafíos éticos. Un algoritmo puede tomar decisiones injustas, reproducir prejuicios presentes en los datos o utilizar información personal de formas que las personas no esperan.
Por ejemplo, un sistema de selección de candidatos podría perjudicar a determinados grupos si aprende de decisiones históricas que contenían discriminación. Aunque el programa funcione correctamente desde el punto de vista técnico, sus resultados podrían ser injustos.
Por eso, desarrollar software ya no consiste únicamente en crear sistemas rápidos y eficientes. También es necesario evaluar sus consecuencias, proteger los derechos de las personas y establecer mecanismos de supervisión.
En este artículo analizamos los principales problemas éticos de la inteligencia artificial, el origen de los sesgos algorítmicos y las medidas que pueden adoptar los desarrolladores para construir sistemas más responsables.
1. ¿Qué es la ética en la inteligencia artificial?
La ética en la inteligencia artificial estudia los principios y responsabilidades que deben orientar el diseño, desarrollo, implementación y utilización de sistemas inteligentes.
Su objetivo es que estas tecnologías aporten beneficios sin generar daños injustificados ni vulnerar derechos fundamentales.
Entre los principios más importantes se encuentran la equidad, la transparencia, la privacidad, la seguridad y la responsabilidad.
La equidad busca evitar que un sistema perjudique injustamente a determinadas personas o colectivos. La transparencia pretende que sus decisiones puedan comprenderse en la medida adecuada al contexto. La privacidad exige proteger la información personal y utilizarla de forma legítima.
La seguridad, por su parte, implica reducir los riesgos técnicos y sociales, mientras que la responsabilidad establece que deben existir personas u organizaciones capaces de responder por el funcionamiento y las consecuencias del sistema.
Estos principios son especialmente importantes cuando una inteligencia artificial interviene en decisiones que afectan al acceso al empleo, los servicios financieros, la educación o la atención sanitaria.
2. ¿Qué son los sesgos algorítmicos?
Un sesgo algorítmico se produce cuando un sistema genera resultados sistemáticamente desfavorables, distorsionados o injustos para determinadas personas o grupos.
Estos sesgos pueden aparecer en diferentes etapas del desarrollo. No siempre proceden del algoritmo en sí: también pueden originarse en los datos, en las decisiones de diseño o en la forma en que se utiliza la tecnología.
Sesgos en los datos de entrenamiento
Los sistemas de aprendizaje automático identifican patrones a partir de ejemplos. Si los datos representan de forma incompleta a determinados grupos, el sistema puede funcionar peor para ellos.
Por ejemplo, un sistema de reconocimiento facial entrenado con imágenes poco diversas podría cometer más errores al identificar a personas que están infrarrepresentadas en el conjunto de entrenamiento.
Sesgos históricos
Los datos también pueden reflejar desigualdades existentes en la sociedad.
Imaginemos una empresa que utiliza registros históricos de contratación para entrenar un sistema que clasifica candidatos. Si las decisiones anteriores favorecieron sistemáticamente a determinados perfiles, el modelo podría aprender a reproducir ese patrón.
Aunque los datos sean auténticos, no significa que representen decisiones justas.
Sesgos de diseño
Los desarrolladores deben decidir qué variables utilizar, qué resultados optimizar y cómo evaluar el rendimiento.
Si un sistema de concesión de créditos se optimiza exclusivamente para reducir las pérdidas económicas, sin considerar adecuadamente los requisitos legales y el riesgo de discriminación, podría generar resultados problemáticos.
Sesgos de interpretación
Un sistema puede producir una predicción estadística que los usuarios interpreten como una certeza. Si una empresa confía ciegamente en sus resultados, puede convertir una recomendación imperfecta en una decisión perjudicial.
Por ello, los sesgos no deben evaluarse únicamente mediante el código: también es necesario analizar el contexto y el uso real de la herramienta.
3. Cómo afectan los sesgos a las personas
Las consecuencias de los sesgos algorítmicos dependen del sector y de las decisiones que automatice el sistema.
En la selección de personal, un algoritmo podría descartar candidatos cualificados por características que no deberían determinar su idoneidad para un puesto.
En el sector financiero, una herramienta podría producir evaluaciones de riesgo injustificadamente desfavorables para determinados grupos, limitando su acceso a créditos.
En educación, un sistema de evaluación automática podría perjudicar a estudiantes cuyas respuestas o formas de expresarse no estén bien representadas en los datos de entrenamiento.
En sanidad, un modelo desarrollado con información poco representativa podría ofrecer predicciones menos fiables para ciertos pacientes.
Estos problemas pueden pasar desapercibidos cuando el rendimiento global del sistema parece elevado. Por ejemplo, un algoritmo puede alcanzar una precisión general alta y, al mismo tiempo, cometer muchos más errores en un grupo concreto.
Por eso, evaluar únicamente el porcentaje total de aciertos no siempre resulta suficiente. Es necesario analizar los resultados por grupos relevantes y comprobar si existen diferencias que requieran investigación.
4. Privacidad y uso responsable de los datos
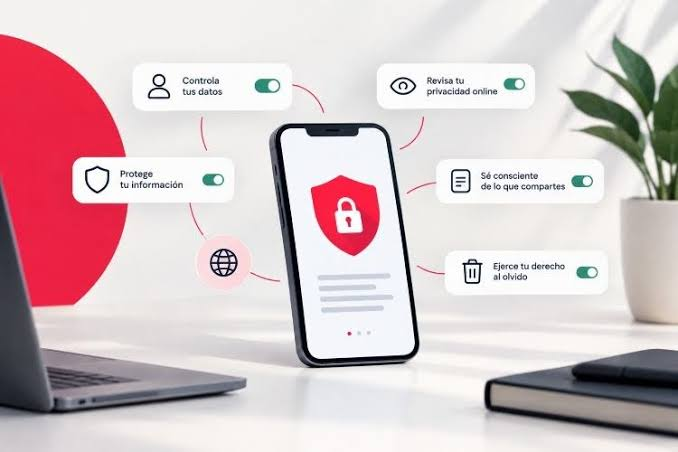
La inteligencia artificial necesita datos para entrenar modelos, generar predicciones o personalizar servicios. Sin embargo, recopilar grandes cantidades de información no significa que todo su uso esté justificado.
Los desarrolladores deben preguntarse qué datos son necesarios, de dónde proceden y con qué finalidad pueden utilizarse.
La información personal debe tratarse de acuerdo con la normativa aplicable, incluido el Reglamento General de Protección de Datos (RGPD) cuando corresponda.
Entre las buenas prácticas destacan minimizar los datos recopilados, limitar los accesos, establecer plazos de conservación y utilizar técnicas de protección adecuadas.
También es importante comprender que eliminar los nombres de una base de datos no garantiza siempre el anonimato. Si otros atributos permiten identificar a una persona al combinarse con información adicional, pueden seguir existiendo riesgos para su privacidad.
En determinados proyectos, las técnicas de seudonimización, la anonimización efectiva o el uso de datos sintéticos pueden ayudar a reducir la exposición de información real.
La decisión debe depender de las características del sistema y de los riesgos identificados, no de asumir que una técnica concreta elimina todos los problemas.
5. Transparencia y explicabilidad de los algoritmos
La transparencia permite conocer aspectos relevantes del funcionamiento de una inteligencia artificial, como su finalidad, sus limitaciones, los datos utilizados y las condiciones en las que debe emplearse.
La explicabilidad va un paso más allá: busca que las personas puedan comprender, en una medida apropiada, por qué el sistema ha producido un resultado determinado.
Esto puede ser sencillo en modelos relativamente simples, pero más complejo en sistemas de aprendizaje profundo con millones de parámetros.
Aun así, existen técnicas que ayudan a examinar la importancia de determinadas variables, identificar patrones y estudiar por qué una predicción cambia cuando se modifica una entrada.
Por ejemplo, si una herramienta ayuda a evaluar solicitudes de financiación, puede ser importante ofrecer información comprensible sobre los factores relevantes para una decisión y permitir que se revisen posibles errores.
No todos los sistemas necesitan el mismo nivel de explicación. Una recomendación de películas presenta riesgos diferentes a una herramienta que influye en decisiones médicas o laborales.
Cuanto mayor sea el impacto sobre las personas, más importante resulta establecer mecanismos adecuados de explicación, revisión y reclamación.
6. Responsabilidad digital: ¿quién responde por los errores?
Cuando un sistema de inteligencia artificial causa un perjuicio, no basta con afirmar que la decisión fue tomada por un algoritmo.
La responsabilidad puede involucrar a distintas partes, como la organización que utiliza el sistema, el proveedor que lo desarrolla y los profesionales que lo integran en un proceso de trabajo. Su alcance concreto depende de las circunstancias y de la normativa aplicable.
Por ello, las empresas deberían establecer responsabilidades claras antes de implantar soluciones basadas en IA.
Es recomendable documentar las decisiones de diseño, registrar las versiones de los modelos, definir quién supervisa sus resultados y establecer procedimientos para investigar incidentes.
También conviene determinar cuándo debe intervenir una persona. En procesos de alto impacto, la revisión humana puede ayudar a detectar errores, aportar contexto y evitar que una predicción automática se convierta en una decisión incuestionable.
Sin embargo, esa supervisión debe ser real. Si los empleados se limitan a aceptar todas las recomendaciones del sistema sin examinarlas, el control humano puede resultar ineficaz.
La responsabilidad digital exige que las organizaciones puedan explicar cómo utilizan la tecnología y qué medidas adoptan para prevenir daños.
7. Cómo desarrollar una inteligencia artificial más ética
La ética debe incorporarse durante todo el ciclo de vida del proyecto, desde la planificación hasta la supervisión posterior a su lanzamiento.
Definir el propósito. Antes de desarrollar un modelo, hay que identificar el problema que resolverá, quién utilizará sus resultados y qué consecuencias podría tener un error.
Revisar los datos. Es necesario comprobar su calidad, representatividad, procedencia y adecuación a la finalidad del proyecto.
Evaluar los resultados por grupos. Las métricas generales deben complementarse, cuando sea pertinente, con análisis que permitan detectar diferencias relevantes entre colectivos.
Documentar las limitaciones. Los usuarios deben conocer las situaciones en las que el sistema puede fallar y evitar utilizarlo fuera del contexto para el que fue diseñado.
Proteger la información. Deben aplicarse controles de acceso, medidas de seguridad y políticas de conservación adecuadas.
Incorporar supervisión humana. Los procesos deben permitir revisar decisiones importantes y corregir errores cuando sea necesario.
Monitorizar después del lanzamiento. El comportamiento de un modelo puede cambiar cuando se modifican los datos, las condiciones de uso o el entorno. Por eso, es necesario comprobar periódicamente su rendimiento y sus posibles efectos adversos.
Estas medidas no garantizan que desaparezcan todos los sesgos, pero permiten identificarlos antes y reducir los riesgos de forma sistemática.
8. Normativa y regulación de la inteligencia artificial
El desarrollo responsable de la inteligencia artificial también está relacionado con las obligaciones legales.
En la Unión Europea, el Reglamento de Inteligencia Artificial establece un marco regulatorio basado en los riesgos asociados a determinados sistemas. Las obligaciones dependen de la categoría del sistema, su finalidad y el papel que desempeña cada organización.
Algunos usos están prohibidos bajo determinadas condiciones, mientras que ciertos sistemas considerados de alto riesgo deben cumplir requisitos específicos, que pueden incluir gestión de riesgos, calidad de los datos, documentación, supervisión humana y seguimiento.
El RGPD sigue siendo relevante cuando se tratan datos personales, independientemente de que el sistema utilice inteligencia artificial.
Por tanto, los equipos de desarrollo deben identificar qué normas resultan aplicables a su proyecto y comprobar los requisitos correspondientes antes de ponerlo en funcionamiento.
Cumplir la normativa es fundamental, pero no sustituye a la reflexión ética. Un sistema puede cumplir determinados requisitos formales y seguir necesitando mejoras para resultar comprensible, útil y justo para sus usuarios.
Conclusión
La ética en la inteligencia artificial es una parte esencial del desarrollo tecnológico responsable. Los sesgos algorítmicos, los problemas de privacidad y la falta de transparencia pueden afectar a las personas incluso cuando un sistema funciona correctamente desde el punto de vista técnico.
Para reducir estos riesgos, los desarrolladores deben revisar los datos, evaluar los resultados, documentar las limitaciones y diseñar mecanismos de supervisión y corrección.
Las empresas, por su parte, necesitan definir responsabilidades y comprobar cómo se comportan sus sistemas en situaciones reales.
En definitiva, desarrollar una inteligencia artificial de calidad no consiste únicamente en mejorar su precisión o automatizar tareas. También implica crear sistemas que respeten los derechos de las personas, permitan detectar errores y se utilicen de manera responsable.