En los primeros meses de aprendizaje, la mayor victoria para cualquier estudiante de desarrollo de software es conseguir que su programa simplemente funcione. Si el código compila sin lanzar errores en rojo por la pantalla y devuelve el resultado esperado, se celebra como un triunfo absoluto. Sin embargo, en la ingeniería de software profesional, que un programa «funcione» es solo el requisito mínimo; el verdadero desafío es conseguir que escale.
Imagina que has programado un buscador para la tienda online de un cliente. Lo pruebas en tu ordenador con una base de datos de prueba de 50 productos. Al escribir «Zapatillas», el resultado aparece en la pantalla de forma instantánea. Orgulloso, subes el código a producción. Tres meses después, el cliente añade 100.000 productos al catálogo. De repente, cada vez que un usuario intenta buscar algo, la página web se queda cargando durante 15 segundos hasta que el servidor colapsa.
El código es exactamente el mismo, no tiene errores de sintaxis, pero ha fracasado estrepitosamente. ¿El motivo? Has escrito un algoritmo ineficiente. Para medir, predecir y evitar este tipo de desastres antes de que ocurran, los ingenieros de software utilizan un lenguaje matemático universal: La Notación Big O (O mayúscula). En este artículo, aprenderemos a evaluar la calidad de nuestro código, entenderemos por qué los bucles anidados son un peligro mortal y descubriremos el algoritmo que hace posible que Google encuentre resultados en milisegundos.
El Problema de Medir el Tiempo con un Cronómetro
La reacción lógica de un programador principiante para medir si su código es rápido o lento es utilizar un cronómetro. En Python, por ejemplo, podrías importar la librería time, registrar la hora antes de que empiece tu función, registrar la hora al terminar, restarlas y decir: «Mi algoritmo tarda 0.4 segundos».
Este enfoque es inútil en la ciencia de la computación. ¿Por qué? Porque el tiempo físico depende del hardware. Ese mismo algoritmo que tarda 0.4 segundos en tu flamante procesador Intel Core i9, tardará 5 segundos si se ejecuta en un servidor virtual barato en la nube, y 15 segundos si se ejecuta en un teléfono móvil antiguo. Además, si mientras se ejecuta tu código tu sistema operativo decide descargar una actualización de Windows en segundo plano, el tiempo se alterará.
Necesitamos una forma de medir la eficiencia de un algoritmo que sea completamente independiente del procesador, de la memoria RAM y del lenguaje de programación. Para lograr esto, la Notación Big O no mide los segundos que tarda un programa, sino cómo crece el número de operaciones que tiene que hacer el procesador a medida que aumenta el tamaño de los datos de entrada (N).
La Jerarquía de la Eficiencia: Leyendo Big O
La notación Big O siempre asume el peor de los casos (el escenario más pesimista). Si estás buscando a un cliente en una base de datos, Big O asume que el cliente que buscas es exactamente el último de la lista.
A continuación, exploraremos las cuatro complejidades de tiempo más comunes que dictarán la vida y la muerte de tus servidores:
1. O(1) – Tiempo Constante (El Santo Grial)
Un algoritmo tiene complejidad O(1) cuando tarda exactamente lo mismo en ejecutarse sin importar si estás procesando 10 datos o 10 millones de datos.
Como vimos en el artículo anterior, el ejemplo perfecto es acceder a una posición de un Array estático. Si tienes un Array de un millón de nombres y ejecutas nombre = lista[50], el procesador va directamente a la coordenada de memoria 50 y lee el dato en una sola operación. La línea es plana. Es la máxima eficiencia posible.
2. O(N) – Tiempo Lineal (El Esfuerzo Proporcional)
Aquí, la «N» representa el número de datos. Un algoritmo O(N) significa que si el tamaño de los datos se multiplica por diez, el número de operaciones también se multiplica por diez. Crece en línea recta.
El ejemplo clásico es un bucle for tradicional (Búsqueda Lineal). Imagina que quieres encontrar el número «7» en una lista desordenada. Tienes que ir comprobando uno por uno: «¿Eres el 7? No. ¿Eres el 7? No». Si la lista tiene 10 números, en el peor de los casos harás 10 comprobaciones. Si tiene 1.000.000 de números, harás un millón de comprobaciones. Es aceptable, pero peligroso si la base de datos es titánica.
3. O(N²) – Tiempo Cuadrático (La Zona de Peligro)
Este es el error de rendimiento más habitual en el desarrollo Backend. Ocurre casi siempre que pones un bucle dentro de otro bucle (Bucles Anidados).
Imagina que tienes una lista de 1.000 correos electrónicos y quieres comprobar si hay alguno duplicado. Un programador júnior escribirá un código que toma el primer correo y lo compara con los otros 999. Luego toma el segundo correo, y lo compara con los 999 restantes. Matemáticamente, esto es N multiplicado por N (N al cuadrado). Para solo 1.000 correos, el procesador tiene que hacer 1.000.000 de operaciones. Si la lista crece a 10.000 correos, las operaciones se disparan a 100 millones. Tu programa se paralizará por completo. Evita los O(N²) en entornos de producción a toda costa.
4. O(log N) – Tiempo Logarítmico (La Magia de la Informática)
Si O(1) es inalcanzable para realizar búsquedas, O(log N) es la estructura que permite que el mundo moderno funcione. Un algoritmo logarítmico es aquel que, cada vez que hace una operación, descarta la mitad de los datos restantes. Su curva de crecimiento es increíblemente plana. Para entenderlo, debemos analizar el algoritmo de búsqueda por excelencia.
Búsqueda Lineal vs Búsqueda Binaria: El Ejemplo Definitivo
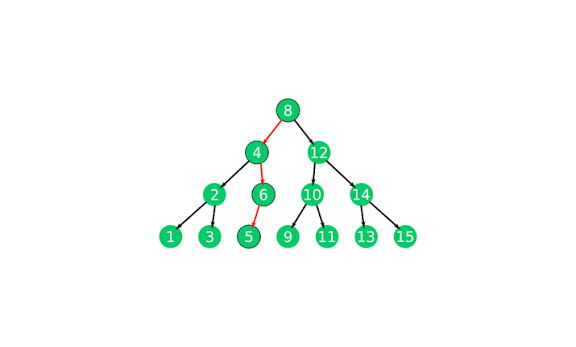
Imagina que te doy un diccionario físico en papel con 1.000 páginas y te pido que busques la definición de la palabra «Programación».
El Enfoque O(N) (Búsqueda Lineal): Abres la página 1, la lees entera. Luego la página 2, la lees entera. Así sucesivamente hasta llegar a la página de la «P». Es un proceso exhaustivo, absurdo y extremadamente lento. En el peor de los casos (si buscas la letra «Z»), leerás las 1.000 páginas.
El Enfoque O(log N) (Búsqueda Binaria): Como sabes que el diccionario está ordenado alfabéticamente (este es un requisito innegociable), utilizas la inteligencia lógica.
- Abres el diccionario exactamente por la mitad (página 500). Cae en la letra «M».
- Sabes que la «P» va después de la «M». En ese instante, acabas de descartar físicamente las primeras 500 páginas. Acabas de eliminar la mitad de tu problema en 1 segundo.
- Ahora te quedan 500 páginas. Lo abres por la mitad (página 750). Cae en la letra «S».
- Sabes que la «P» va antes de la «S». Descartas la mitad superior.
Si repites este proceso de dividir el problema a la mitad, ¿sabes cuántas operaciones necesitas para encontrar la palabra exacta en un libro de 1.000 páginas? Apenas 10 operaciones.
La verdadera maravilla matemática del O(log N) se revela a gran escala. Si tuviéramos un diccionario gigantesco de 1.000.000 de páginas, la búsqueda lineal tardaría un millón de pasos. La Búsqueda Binaria lo encontraría en apenas 20 pasos. Si pasamos a mil millones de datos, lo encontrará en 30 pasos. Esta es la razón técnica por la que una base de datos puede encontrar el perfil de un usuario entre millones de registros en 0.01 segundos.
Veamos cómo se traduce esto a código limpio en Python:
Python
def busqueda_binaria(lista_ordenada, objetivo):
    limite_izquierdo = 0
    limite_derecho = len(lista_ordenada) - 1

    # Mientras los límites no se crucen
    while limite_izquierdo <= limite_derecho:

        # Calculamos el punto medio exacto
        medio = (limite_izquierdo + limite_derecho) // 2

        if lista_ordenada[medio] == objetivo:
            return medio # ¡Encontrado! Devolvemos la posición

        elif lista_ordenada[medio] < objetivo:
            # El objetivo está en la mitad derecha, descartamos la izquierda
            limite_izquierdo = medio + 1

        else:
            # El objetivo está en la mitad izquierda, descartamos la derecha
            limite_derecho = medio - 1

    return -1 # El dato no existe en la lista
Ordenación de Datos (Sorting): El Precio de Organizar
Como acabamos de comprobar, para poder utilizar el mágico algoritmo O(log N) de búsqueda binaria, la lista tiene que estar ordenada previamente. Ordenar datos es una de las tareas computacionales más costosas que existen.
Si intentas ordenar una lista utilizando el algoritmo más básico e intuitivo que existe (el Método Burbuja o Bubble Sort), que consiste en usar bucles anidados para comparar el elemento 1 con el 2, luego el 2 con el 3, e ir intercambiándolos, estarás cayendo en la trampa del O(N²). Para ordenar un millón de clientes, tu servidor colapsará.
La industria del software resolvió este problema inventando algoritmos de ordenación avanzados basados en la técnica de «Divide y Vencerás», como el Merge Sort o el Quick Sort. Estos algoritmos trocean la lista en pedazos diminutos de forma recursiva, los ordenan internamente y los vuelven a ensamblar. Su complejidad matemática es O(N log N). No son tan rápidos como una búsqueda binaria pura, pero son infinitamente superiores al desastre del O(N²), convirtiéndose en el estándar universal que utilizan por defecto lenguajes como Java o Python cuando llamas a su función nativa .sort().
Conclusión: Por Qué a las Empresas les Importa Big O
En el ecosistema tecnológico actual, el hardware es barato, pero a la escala de corporaciones gigantes, la ineficiencia cuesta millones.
Cuando acudas a una entrevista técnica para una posición de desarrollador (especialmente en grandes empresas tecnológicas), rara vez te pedirán que programes un bucle for básico. Te pondrán un problema de lógica y, una vez que lo resuelvas y el código funcione, el entrevistador te hará la pregunta que define tu nivel de Seniority: «¿Cuál es la complejidad Big O de tu solución y cómo podemos optimizarla?».
Si tu código utiliza dos bucles anidados para cruzar datos (O(N²)), estarás demostrando que tu solución no puede ir a producción. El desarrollador profesional sabe cómo refactorizar ese algoritmo, quizás transformando una de las listas en un diccionario (Hash Map) para reducir la complejidad a O(N).
Escribir código que funcione es programación; comprender cómo se comportará ese código cuando se enfrente a la carga brutal del mundo real utilizando la notación Big O, es verdadera Ingeniería de Software.