En el viaje de aprendizaje de cualquier desarrollador de software, existen ciertos conceptos que actúan como «muros de contención». Son ideas que exigen un cambio drástico en la forma en la que el cerebro humano procesa la información. Entender un bucle for o un condicional if es relativamente sencillo porque son instrucciones lineales, mecánicas y tangibles. Sin embargo, hay un concepto matemático y algorítmico que suele provocar cortocircuitos mentales en los estudiantes durante semanas: la Recursividad.
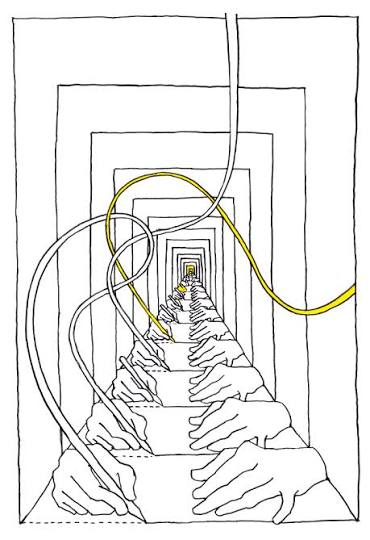
Visualiza el efecto óptico que se produce cuando colocas un espejo frente a otro espejo: un reflejo infinito que se contiene a sí mismo. O piensa en las famosas muñecas rusas (Matrioskas), donde al abrir una muñeca grande, encuentras una versión idéntica pero más pequeña en su interior, y así sucesivamente.
En el ámbito de la ingeniería de software, la recursividad ocurre cuando una función se llama a sí misma desde dentro de su propio código para resolver un problema. En este artículo, desmitificaremos este temido concepto, analizaremos la anatomía de un algoritmo recursivo para evitar destruir la memoria de nuestro ordenador, y descubriremos por qué es la herramienta definitiva para resolver problemas donde los bucles tradicionales fracasan estrepitosamente.
La Anatomía de una Función Recursiva
Para que una función recursiva sea una herramienta útil y no un virus informático que colapse tu sistema, debe estar construida obligatoriamente sobre dos pilares arquitectónicos innegociables. Si falta uno de los dos, el programa fallará.
1. El Caso Base (La Válvula de Escape)
El caso base es la condición de parada. Es una versión del problema tan pequeña, tan trivial y tan ridículamente sencilla que la función puede devolver una respuesta directa sin necesidad de volver a llamarse a sí misma.
Si retomamos la analogía de las muñecas rusas, el caso base es la muñeca más diminuta de todas: la que es de madera maciza y ya no se puede abrir más. Si tu función recursiva no tiene un caso base perfectamente definido, el programa entrará en un ciclo infinito de llamadas.
2. El Caso Recursivo (El Salto de Fe)
Es la parte de la función que contiene la lógica principal. Aquí, la función coge el problema grande, realiza una pequeña parte del trabajo y se llama a sí misma pasándole el resto del problema, pero en una versión reducida.
La clave del éxito del caso recursivo es que, en cada nueva llamada, el parámetro que se pasa a la función debe acercarse un poco más al Caso Base.
El Clásico Matemático: El Cálculo del Factorial
Casi todas las universidades y bootcamps de programación del mundo enseñan la recursividad utilizando el mismo ejemplo matemático: el Factorial de un número.
En matemáticas, el factorial de 5 (escrito como 5!) es el resultado de multiplicar 5 por todos los números enteros inferiores hasta llegar al 1. Es decir: 5! = 5 * 4 * 3 * 2 * 1 = 120.
Si miras esta operación con una mente computacional orientada a buscar patrones (como aprendimos en el primer artículo de esta categoría), te darás cuenta de algo fascinante:5! = 5 * 4! Y a su vez, 4! = 4 * 3!.
El problema grande se compone de versiones más pequeñas del mismo problema. Veamos cómo se programa esto de forma limpia y elegante en Python utilizando la recursividad:
Python
def calcular_factorial(n):
    # 1. EL CASO BASE: La parada de emergencia
    # Si nos piden el factorial de 1 (o 0), la respuesta matemática es 1.
    if n == 1 or n == 0:
        return 1

    # 2. EL CASO RECURSIVO: La magia
    # Multiplicamos el número actual (n) por el factorial del número anterior (n-1)
    else:
        return n * calcular_factorial(n - 1)

# Probamos la función
resultado = calcular_factorial(5)
print(f"El factorial de 5 es: {resultado}")
¿Qué ocurre realmente en la memoria del ordenador?
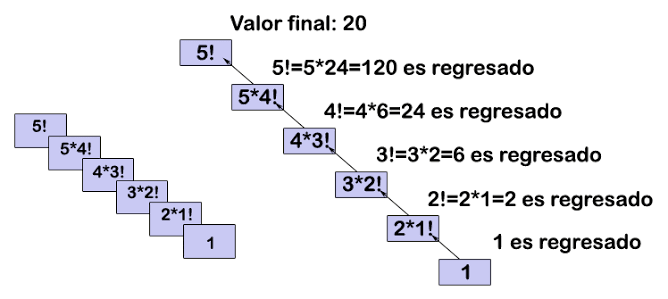
Cuando llamas a calcular_factorial(5), el código llega al else y dice: «Tengo que multiplicar 5 por… un momento, no sé cuál es el factorial de 4. Voy a pausar esta función y a llamar a calcular_factorial(4)».
Ese proceso de pausar y llamar genera una cadena de operaciones pendientes:
factorial(5)espera a5 * factorial(4)factorial(4)espera a4 * factorial(3)factorial(3)espera a3 * factorial(2)factorial(2)espera a2 * factorial(1)factorial(1)alcanza el Caso Base. No espera a nadie. Devuelve un1.
Una vez que el caso base devuelve un número real, la cadena se desencadena hacia atrás (fase de retorno). El 1 se multiplica por 2; el resultado (2) sube y se multiplica por 3; el resultado (6) sube y se multiplica por 4; el resultado (24) sube y se multiplica por 5, devolviendo finalmente el 120.
El Peligro Oculto: El «Stack Overflow»
En el artículo donde analizamos las Estructuras de Datos, hablamos de la Pila de Llamadas (Call Stack), un sistema LIFO (Último en Entrar, Primero en Salir).
Debes comprender que cada vez que una función se llama a sí misma, el sistema operativo tiene que coger todas las variables locales de esa función, empaquetarlas y meterlas en la memoria RAM (hacer un Push a la Pila) para «pausarla» de forma segura.
¿Qué pasa si te equivocas programando el Caso Base o si pides calcular_factorial(100000)? La función se llamará a sí misma cien mil veces. La Pila de Llamadas crecerá, crecerá y crecerá, almacenando cientos de miles de funciones pausadas en la RAM. Eventualmente, el espacio reservado para la Pila se agotará.
Cuando esto ocurre, el sistema operativo entra en pánico y asesina violentamente a tu programa para evitar que bloquee todo el ordenador, lanzando el error informático más famoso de la historia: StackOverflowError. (Sí, de aquí recibe su nombre la famosa página web de preguntas y respuestas para programadores).
El Mundo Real: ¿Por qué no usar simplemente un bucle while?
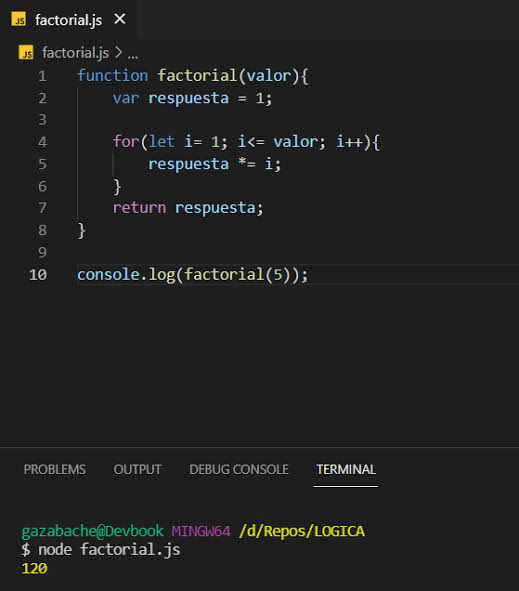
Al ver el ejemplo del factorial, un desarrollador pragmático podría pensar: «Esto es una complicación académica absurda. Puedo calcular el factorial de 5 usando un simple bucle for o while sin arriesgarme a un Stack Overflow y consumiendo muchísima menos RAM».
Y tendría toda la razón del mundo. En el desarrollo Backend profesional, nunca utilizamos la recursividad para cálculos matemáticos lineales. Los bucles iterativos son infinitamente más eficientes a nivel de rendimiento de CPU y memoria.
Entonces, ¿cuándo es imprescindible la recursividad? Cuando nos enfrentamos a estructuras de datos jerárquicas o en forma de árbol, de profundidad desconocida.
Caso de Uso Crítico: Navegando por el Sistema de Archivos
Imagina que estás escribiendo un script para escanear el disco duro de un servidor en busca de un archivo llamado config.json.
El disco duro tiene carpetas. Si entras en una carpeta usando un bucle, puedes listar lo que hay dentro. Pero resulta que dentro hay otras carpetas. Y dentro de esas, más carpetas. ¿Cuántos bucles for anidados necesitas escribir? ¿Tres? ¿Diez? ¿Cincuenta? Es imposible saberlo de antemano. Un usuario podría haber creado una estructura de 30 carpetas una dentro de otra. La iteración tradicional (los bucles) colapsa ante problemas de profundidad desconocida.
Aquí es donde la recursividad brilla con una elegancia inigualable. El algoritmo recursivo para buscar un archivo es casi poético:
Python
import os

def buscar_archivo(ruta_carpeta, nombre_objetivo):
    # Obtenemos todo lo que hay dentro de la carpeta actual
    elementos = os.listdir(ruta_carpeta)

    for elemento in elementos:
        ruta_completa = os.path.join(ruta_carpeta, elemento)

        # CASO BASE 1: Es un archivo y es el que buscamos
        if os.path.isfile(ruta_completa) and elemento == nombre_objetivo:
            return f"¡Encontrado en: {ruta_completa}!"

        # CASO RECURSIVO: Es una carpeta.
        # La función se llama A SÍ MISMA para investigar por dentro.
        elif os.path.isdir(ruta_completa):
            resultado = buscar_archivo(ruta_completa, nombre_objetivo)
            # CASO BASE 2: Si el archivo se encontró en la profundidad, propagar el éxito
            if resultado:
                return resultado

    # Si revisa todo y no lo encuentra, devuelve vacío
    return None
Con menos de 15 líneas de código, este algoritmo es capaz de navegar de forma automática e inteligente por discos duros enteros con millones de archivos y miles de niveles de carpetas de profundidad. La función simplemente se sumerge en las carpetas llamándose a sí misma, y cuando llega a un «callejón sin salida» (una carpeta vacía, que actúa como caso base natural), retrocede elegantemente para probar la siguiente ruta.
Recursividad vs Iteración: El Veredicto Final
En la ingeniería de software moderna, la elección entre usar un bucle tradicional o una función recursiva es un clásico debate de diseño arquitectónico.
- Rendimiento y Memoria: La iteración (bucles
for/while) siempre gana. Los bucles no apilan llamadas en la memoria RAM y son procesados a velocidad vertiginosa por la CPU. - Legibilidad y Diseño: La recursividad gana por goleada cuando el problema es inherentemente jerárquico. Modificar estructuras web (el DOM en HTML), buscar archivos en carpetas, procesar respuestas JSON altamente anidadas provenientes de una API externa, o recorrer bases de datos en formato de «Árbol Genealógico» son tareas que, hechas con bucles, generan cientos de líneas de código espagueti ilegible.
Comprender la recursividad representa el momento exacto en el que dejas de pensar como un simple «picador de código» y empiezas a pensar como un matemático computacional. Confiar en que la función hará su trabajo, diseñar un caso base sólido para evitar el desastre del Stack Overflow y ver cómo un problema complejo se resuelve a sí mismo en tres líneas de código, es una de las experiencias más satisfactorias que puede experimentar un desarrollador.