En los primeros compases de nuestro aprendizaje como desarrolladores, nos acostumbramos a guardar la información en variables simples. Declaramos edad = 20 o nombre = "Juan", y el sistema operativo reserva un diminuto espacio en la memoria RAM para almacenar ese dato aislado. Sin embargo, ¿qué ocurre cuando el mundo real entra en juego? ¿Qué pasa si estás programando el Backend de una red social y necesitas almacenar los nombres de los dos millones de seguidores de un usuario?
No puedes declarar dos millones de variables (seguidor_1, seguidor_2…). Sería insostenible. Necesitas contenedores capaces de agrupar cantidades masivas de información bajo un mismo nombre, permitiéndote utilizar los bucles for y while que vimos en capítulos anteriores para procesarlos a la velocidad de la luz.
A estos contenedores los llamamos Estructuras de Datos. No todas las cajas son iguales; algunas están diseñadas para leer datos instantáneamente, otras para insertar datos nuevos a gran velocidad, y otras para mantener un orden estricto de llegada. Elegir la estructura equivocada puede hacer que tu aplicación tarde 10 segundos en cargar en lugar de 10 milisegundos. En este artículo, desgranaremos las cuatro estructuras lineales más importantes de la informática: Arrays, Listas, Pilas y Colas.
1. Arrays (Arreglos): La Eficiencia de la Rigidez
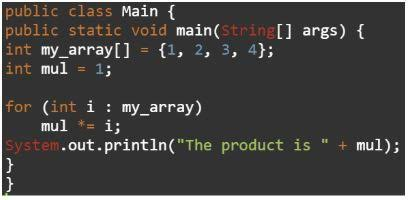
El Array es el abuelo de todas las estructuras de datos. Es la forma más primitiva, rápida y cercana al hardware (Bare-Metal) para almacenar múltiples elementos.
Cuando declaras un Array en lenguajes fuertemente tipados (como Java o C++), debes decirle al sistema operativo dos cosas innegociables antes de empezar: qué tipo de dato vas a guardar (por ejemplo, números enteros) y cuántos elementos exactos va a tener el Array (por ejemplo, 10).
Java
// Ejemplo en Java: Un Array estático de 5 enteros
int[] notas = new int[5];
notas[0] = 8;
notas[1] = 7;
¿Por qué son tan rápidos? (La Memoria Contigua)
Cuando haces esa declaración, el sistema operativo busca un bloque de memoria RAM que esté completamente vacío y contiguo (uno detrás de otro) y lo bloquea con hormigón. Como los datos están pegados físicamente en el chip de memoria, si el procesador quiere leer la nota número 4, no tiene que buscarla: sabe matemáticamente en qué coordenada física de la RAM se encuentra basándose en la posición del primer elemento. La lectura es instantánea, sin importar si el Array tiene 5 elementos o 50 millones.
El Gran Problema del Array
Su mayor virtud es su mayor defecto. Como el bloque de memoria está bloqueado con hormigón, un Array no puede crecer. Si creaste un Array para 100 clientes y tu empresa consigue el cliente 101, el programa estallará (el famoso error IndexOutOfBoundsException). Para solucionarlo, el ordenador tiene que crear un Array nuevo de 200 posiciones en otra parte de la RAM y copiar uno a uno los 100 clientes antiguos al nuevo contenedor, lo cual es un proceso computacionalmente carísimo.
2. Listas Dinámicas: La Flexibilidad Moderna
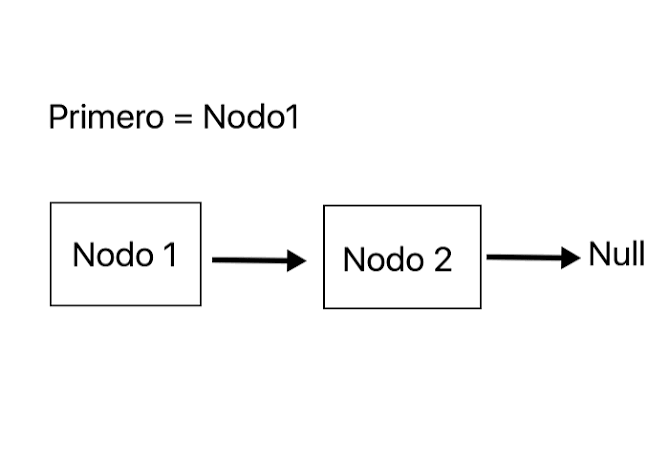
Para solucionar el problema de la rigidez de los Arrays estáticos, la ingeniería de software inventó las Listas Dinámicas (conocidas como ArrayList en Java o simplemente list en Python).
Las listas son las estructuras de datos por defecto que vas a utilizar en el 90% de tu día a día como desarrollador. Para ti, como programador, parecen contenedores infinitos. Puedes seguir añadiendo elementos usando la función .append() (o .add()) y la lista crecerá mágicamente, adaptándose a tus necesidades sin que tengas que preocuparte de la RAM.
Python
# Ejemplo en Python: Las listas son dinámicas por naturaleza
clientes = ["Carlos", "María"]

# Podemos añadir datos infinitamente, la lista crece sola
clientes.append("Juan")
clientes.append("Sofía")

# Podemos mezclar tipos de datos (aunque no es buena práctica)
clientes.append(2026)
La Magia Negra bajo el Capó
¿Cómo logra Python o Java que la lista crezca si dijimos que la RAM necesita bloques contiguos? Las listas dinámicas hacen trampa. En realidad, bajo la superficie, son Arrays normales.
Cuando creas una lista vacía, Python en secreto crea un Array estático de, por ejemplo, 4 posiciones. Cuando añades el quinto elemento y te quedas sin espacio, Python detiene tu programa un milisegundo, crea un nuevo Array estático del doble de tamaño (8 posiciones), copia los datos antiguos, destruye el pequeño, y añade tu nuevo elemento. Todo esto ocurre de forma invisible para ti. Esta flexibilidad extrema las hace maravillosas para el desarrollo diario, pero debes ser consciente de que abusar de ellas (insertar elementos constantemente en el medio de una lista gigante) puede ocultar graves cuellos de botella en el rendimiento de tu aplicación.
3. Pilas (Stacks): El Protocolo LIFO
Avanzando en la abstracción, entramos en las estructuras lógicas. Una Pila (Stack) no se define por cómo se guarda en la RAM, sino por las reglas estrictas de cómo puedes interactuar con ella.
El acrónimo que define a una Pila es LIFO (Last In, First Out – El último en entrar, es el primero en salir).
La analogía perfecta es una pila de platos sucios en el fregadero. Si vas añadiendo platos (uno encima de otro), y luego alguien te pide que laves un plato, no intentas sacar el que está aplastado en el fondo; coges el plato que está en la cima (el último que pusiste).
Una Pila en programación solo permite dos operaciones fundamentales:
- Push (Apilar): Añade un elemento a la cima.
- Pop (Desapilar): Saca y elimina el elemento que está en la cima.
¿Para qué sirve una Pila en el mundo real?
Las Pilas gobiernan funciones críticas de la informática:
- El botón de «Deshacer» (Ctrl+Z): Cada vez que escribes una palabra en Word, la acción hace un Push a una pila. Cuando pulsas Ctrl+Z, Word hace un Pop y destruye la última acción que realizaste, volviendo al estado anterior.
- El Historial del Navegador: Cada vez que haces clic en un enlace, la URL actual se apila. Cuando le das a la flecha de «Atrás», el navegador desapila la última URL para volver a ella.
- El Call Stack (Pila de Llamadas): Es el corazón de cualquier lenguaje de programación. Cuando una Función A llama a una Función B, el ordenador debe recordar a dónde volver cuando B termine. El ordenador apila la Función A, ejecuta la B, y cuando termina, hace un Pop para retomar la A exactamente donde la dejó.
4. Colas (Queues): El Protocolo FIFO
La estructura complementaria (y opuesta) a la Pila es la Cola (Queue).
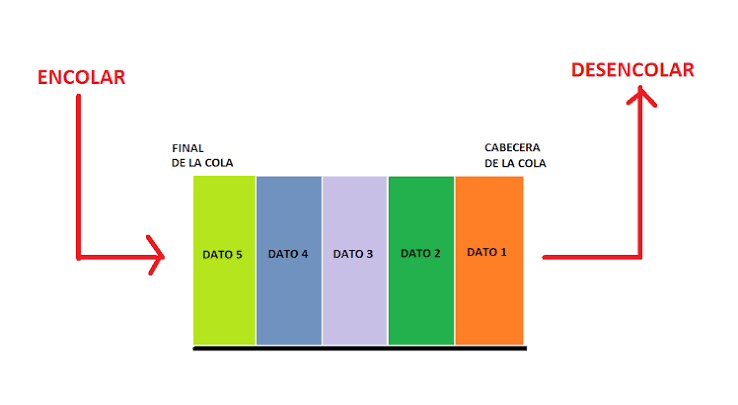
Su acrónimo rector es FIFO (First In, First Out – El primero en entrar, es el primero en salir). Esta es la estructura más justa de la informática, y su analogía es idéntica a la vida real: la cola de un supermercado. El primer cliente que llega a la caja es el primero en ser atendido. El que llega último se pone al final de la fila y debe esperar su turno pacientemente.
Las dos operaciones críticas de una Cola son:
- Enqueue (Encolar): Añade un elemento al final de la fila.
- Dequeue (Desencolar): Saca y procesa al elemento que está en la cabeza de la fila.
El Peligro de Usar Listas como Colas en Python
Muchos desarrolladores júnior intentan simular una Cola utilizando una simple lista de Python. Hacen lista.append() para encolar (lo cual es muy rápido) y luego hacen lista.pop(0) para sacar al primero de la fila.
Esto es un desastre de rendimiento. Al sacar al cliente de la posición 0, la posición 0 se queda vacía. El sistema operativo se ve obligado a coger a todos los clientes restantes (imagina que hay un millón) y desplazarlos físicamente una posición hacia la izquierda en la memoria RAM para rellenar el hueco.
Para implementar Colas profesionales, Python ofrece una estructura especializada llamada deque (Double Ended Queue) dentro de la librería collections, diseñada matemáticamente para sacar elementos del principio sin tener que desplazar al resto.
Python
from collections import deque

# Implementación profesional de una Cola
cola_impresion = deque()

# Llegada de trabajos de impresión (Enqueue)
cola_impresion.append("Documento_PDF.pdf")
cola_impresion.append("Foto_Vacaciones.jpg")

# Procesamiento del trabajo más antiguo (Dequeue)
siguiente_trabajo = cola_impresion.popleft()
print(f"Imprimiendo: {siguiente_trabajo}") # Imprimirá el PDF
¿Para qué sirve una Cola en el mundo real?
- Colas de Impresión: Como en el ejemplo anterior, si 5 empleados mandan a imprimir un documento a la vez, la impresora los procesa en el orden estricto de llegada.
- Procesamiento Asíncrono en Backend: En arquitecturas de servidores masivos, si mil usuarios intentan subir una foto al mismo tiempo, el servidor no intenta procesar las mil fotos a la vez (colapsaría). Coloca las peticiones en un sistema de colas (como RabbitMQ o Celery). Una serie de procesos en segundo plano (Workers) irán cogiendo fotos de la cabeza de la cola, procesándolas una a una sin estresar al servidor principal.
- Buffer de Streaming: Cuando ves Netflix, el reproductor descarga paquetes de vídeo y los mete en una cola. La pantalla va cogiendo los paquetes de la cabeza de la cola para reproducirlos fluidamente mientras la red sigue llenando la cola por detrás.
Conclusión
Saber declarar variables es el requisito mínimo para programar, pero dominar las Estructuras de Datos es lo que separa a un simple codificador de un verdadero Arquitecto de Software.
Cuando te enfrentes a un problema de desarrollo, la primera pregunta que debe cruzar tu mente no es cómo escribir el bucle for, sino qué contenedor utilizar para almacenar tus datos.
- ¿Necesitas almacenar un número exacto de elementos, inmutables y acceder a ellos a máxima velocidad? Usa un Array.
- ¿Necesitas un contenedor de propósito general que pueda crecer dinámicamente para guardar colecciones de usuarios? Usa una Lista.
- ¿Necesitas implementar un sistema de navegación con histórico o un botón de deshacer? Usa una Pila (LIFO).
- ¿Necesitas procesar peticiones web de forma ordenada, justa y asíncrona para no saturar tu base de datos? Usa una Cola (FIFO).
La eficiencia de tu software estará dictada, casi en su totalidad, por la estructura de datos sobre la que construyas tu lógica matemática. En el siguiente paso de nuestra travesía, uniremos las estructuras iterativas con estas cajas de datos para adentrarnos en el fascinante (y a menudo temido) mundo del rendimiento algorítmico y la notación Big O.