Existe un momento universal en la vida de todo desarrollador. Has pasado las últimas tres horas diseñando la lógica de una función compleja. Has dibujado el ordinograma, has aplicado cláusulas de guarda para evitar el código espagueti y has estructurado tus bucles perfectamente. Con una mezcla de orgullo y nerviosismo, pulsas el botón de «Ejecutar». El programa compila sin errores de sintaxis, la consola se abre y… el resultado que escupe la pantalla es un absoluto desastre. Los cálculos matemáticos son incorrectos, los usuarios no se guardan en la base de datos y la aplicación se cierra de golpe sin previo aviso.
La reacción instintiva de la mente humana ante este fracaso es la frustración, seguida de la negación: «Pero si el código está perfecto, el error tiene que ser del ordenador». La cruda realidad de la ingeniería de software es que el ordenador hace exactamente lo que tú le has ordenado que haga, ni más, ni menos.
Aceptar que el error es tuyo es el primer paso. El segundo paso es encontrarlo. A este proceso de investigación detectivesca se le llama Depuración o Debugging. En este artículo final de nuestra categoría de algoritmia, exploraremos la anatomía de los errores informáticos, abandonaremos las técnicas de aficionados y aprenderemos a utilizar herramientas profesionales para congelar el tiempo y diseccionar la memoria de nuestro software en tiempo real.
1. La Anatomía del Fracaso: Los Tres Tipos de Errores
Antes de poder cazar un bug (error), debes entender a qué especie pertenece. En el desarrollo de software, los errores no son todos iguales; se dividen en tres grandes familias, catalogadas por el momento exacto en el que dan la cara:
A) Errores de Sintaxis (Los gritos del compilador)
Son los más escandalosos, pero paradójicamente, los más fáciles de solucionar. Ocurren cuando rompes las reglas gramaticales del lenguaje de programación: olvidar un punto y coma al final de una línea en Java, no indentar correctamente un bloque de código en Python o abrir un paréntesis que nunca cierras. El entorno de desarrollo (IDE) los detecta al instante, subraya la línea en rojo y se niega categóricamente a ejecutar el programa hasta que lo arregles. El ordenador te está diciendo exactamente dónde y por qué ha fallado.
B) Errores de Tiempo de Ejecución (Runtime Errors)
El código es gramaticalmente perfecto, por lo que el programa arranca sin problemas. Sin embargo, durante la ejecución, el software intenta hacer algo que es físicamente o matemáticamente imposible. Ejemplos clásicos:
- Intentar dividir un número entre cero.
- Intentar acceder a la posición 100 de un Array que solo tiene 10 posiciones (
IndexOutOfBoundsException). - Intentar leer el nombre de un usuario que no existe en la base de datos y cuyo valor es nulo (
NullPointerException). Estos errores provocan el cierre forzoso (el crasheo) de la aplicación, lanzando una traza de error en la consola que detalla qué línea exacta provocó la explosión.
C) Errores Lógicos (Los Asesinos Silenciosos)
Son, con diferencia, la peor pesadilla de cualquier desarrollador. El código compila perfectamente y el programa jamás se bloquea ni lanza pantallas de error. Funciona con una suavidad pasmosa, pero hace lo que no debe. Has programado un carrito de la compra y, al aplicar un descuento del 10%, el sistema, en lugar de restar dinero, se lo suma al precio final. El ordenador no sabe que esto es un error; él simplemente está ejecutando la fórmula matemática errónea que tú le proporcionaste (precio_final = precio + descuento en lugar de precio - descuento). Estos son los errores que exigen verdaderas habilidades de debugging.
2. La Técnica del Aficionado: El «Print Debugging»
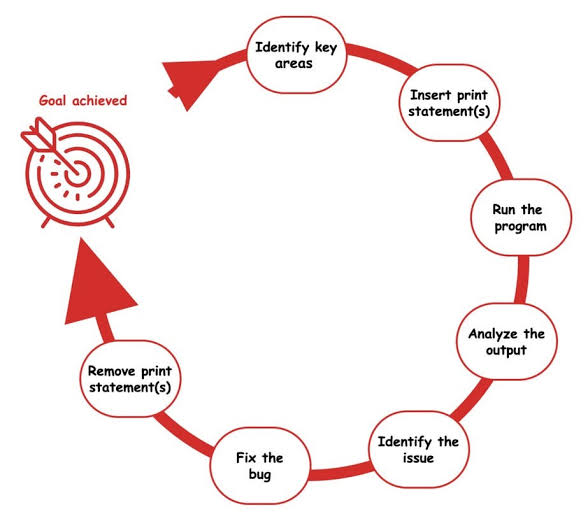
Cuando un programador júnior se enfrenta a un error lógico, su primera y única herramienta de defensa suele ser inundar el código con sentencias de impresión por pantalla (print() en Python, System.out.println() en Java o console.log() en JavaScript).
Intentan adivinar por dónde está pasando el flujo de ejecución insertando mensajes como:
Python
print("Llega hasta aquí 1")
resultado = calcular_impuestos(precio)
print(f"El resultado intermedio es: {resultado}")
print("Llega hasta aquí 2")
Aunque esta técnica puede salvarte de un apuro rápido en scripts de veinte líneas, es absolutamente insostenible en arquitecturas profesionales.
- Ensucia el código fuente con docenas de líneas inútiles.
- Si olvidas borrar uno de estos
printsantes de subir el código a producción, los usuarios podrían ver mensajes de depuración en sus pantallas o llenarías los registros del servidor de basura. - Es estático. Si imprimes una variable y te das cuenta de que el error estaba en otra variable diferente, tienes que detener el programa, escribir otro
print, y volver a ejecutarlo todo desde el principio.
3. El Arsenal del Profesional: El Debugger del IDE
Todo entorno de desarrollo moderno (como Visual Studio Code, IntelliJ IDEA o Eclipse) incluye una herramienta milagrosa que separa a los aficionados de los profesionales: El Depurador (Debugger).
El Debugger te otorga un poder que parece ciencia ficción: la capacidad de congelar el tiempo de ejecución de tu programa a voluntad y mirar dentro de la memoria RAM del ordenador.
Para dominarlo, solo necesitas comprender tres conceptos fundamentales:
A) El Punto de Interrupción (Breakpoint)
En el margen izquierdo de tu editor de código (junto a los números de línea), puedes hacer clic para colocar un punto rojo brillante. Acabas de crear un Breakpoint. Cuando ejecutas el programa en «Modo Debug», el software funcionará a máxima velocidad hasta que llegue a esa línea exacta. En ese milisegundo, el programa se congela por completo. La pantalla de tu aplicación se quedará pausada, esperando tus órdenes.
B) Navegación Paso a Paso
Una vez que el tiempo está congelado, el IDE te mostrará una pequeña barra de herramientas de navegación temporal:
- Step Over (Paso a paso por procedimientos): Ejecuta la línea actual y se congela en la inmediatamente inferior. Te permite ver cómo avanza el programa a cámara lenta, instrucción por instrucción.
- Step Into (Paso a paso por instrucciones): Si la línea actual es una llamada a una función compleja (ej.
calcular_nómina()), este botón te «teletransporta» directamente a las entrañas de esa función para que veas qué ocurre en su interior. - Step Out (Salir de la instrucción): Si entraste en una función y ya viste suficiente, este botón ejecuta el resto de la función a velocidad normal y vuelve a pausarse justo al salir de ella.
C) La Inspección de Variables (Watch & Variables)
Esta es la verdadera magia. Mientras el tiempo está congelado en un Breakpoint, el IDE abrirá un panel lateral donde te mostrará absolutamente todas las variables, arrays y listas que existen en la memoria en ese nanosegundo exacto. No necesitas escribir prints. Puedes ver qué valor exacto tiene el carrito de la compra, qué datos hay dentro del usuario actual e incluso modificar los valores de la memoria «al vuelo» para ver cómo reaccionaría el resto del programa si el saldo del cliente fuera diferente, todo ello sin tener que reiniciar la aplicación.
4. El Factor Psicológico: El Método del «Patito de Goma»
Incluso con el mejor debugger del mundo, hay ocasiones en las que pasas horas mirando una línea de código y el error lógico sigue siendo invisible a tus ojos. Tu cerebro está tan saturado de información y tan convencido de que la lógica es correcta, que literalmente omite el fallo al leer.
En 1999, el famoso libro The Pragmatic Programmer documentó una de las técnicas de resolución de problemas más efectivas, extrañas y universales de la industria tecnológica: El Debugging del Patito de Goma (Rubber Duck Debugging).
La técnica consiste en colocar un patito de goma (o una figura de acción, o un peluche) encima de tu monitor. Cuando te quedes atascado en un error incomprensible, debes explicarle a ese objeto inanimado, en voz alta y línea por línea, qué se supone que hace tu código.
«Mira, patito. Aquí el programa recibe el DNI del usuario. Luego entra en este bucle for y revisa la base de datos. Si el DNI coincide… espera. ¡No estoy guardando el resultado del DNI en ninguna parte!».
¿Por qué funciona esta técnica aparentemente ridícula? Porque al obligarte a articular la lógica en lenguaje natural hablado, fuerzas a tu cerebro a ralentizar su procesamiento y abandonar las asunciones implícitas que estabas haciendo mentalmente. Al tener que explicar cada paso minucioso, la desconexión entre lo que creías que le habías ordenado al ordenador y lo que realmente has escrito se vuelve dolorosamente obvia.
5. El Escenario Inevitable: El Debugging en Producción
El Debugger con sus puntos de interrupción es la herramienta perfecta cuando estás desarrollando en tu máquina local. Pero, ¿qué ocurre cuando el error lógico solo le sucede a un cliente concreto un domingo por la tarde, mientras tu código está ejecutándose en un servidor Linux en la nube a miles de kilómetros de distancia?
No puedes conectar tu Visual Studio Code al servidor de producción y congelar el tiempo; paralizarías la aplicación para los otros diez mil usuarios que la están usando en ese momento.
Para solucionar este abismo, la industria utiliza la Trazabilidad y el Logging. En lugar de depender de la consola local, el código profesional integra librerías de registro de eventos (como Log4j en Java o la librería logging en Python). Estas librerías escriben constantemente pequeños archivos de texto (logs) en el disco duro del servidor de forma silenciosa, categorizados por niveles de severidad:
- [INFO]: «El usuario Juan ha iniciado sesión correctamente.»
- [WARN]: «Advertencia: El usuario intentó introducir una contraseña con caracteres inválidos.» (El sistema no ha fallado, pero es un comportamiento anómalo).
- [ERROR]: «Excepción Crítica en la pasarela de pago: El servidor del banco no responde.»
Cuando el programa falla en el mundo real, el desarrollador Backend se conecta al servidor mediante SSH (como aprendimos en la categoría de sistemas), abre los archivos de logs de las últimas horas, y lee el rastro de migas de pan que el sistema fue dejando antes de colapsar.
Conclusión
Depurar código no es un castigo por ser un mal programador. Escribir bugs es una parte inherente e inevitable de la traducción de la lógica humana a la lógica de la máquina. Incluso los arquitectos de software más experimentados del mundo pasan más tiempo depurando código existente que escribiendo código nuevo.
Aprender a depurar es aprender a no entrar en pánico. Significa abandonar la frustración ciega y adoptar un enfoque científico: aislar el problema, establecer puntos de interrupción quirúrgicos, observar la memoria de forma metódica y entender el flujo exacto de los datos. Cuando dejas de depender de los prints caóticos y empiezas a navegar por el tiempo de ejecución de tu software con el aplomo de un cirujano, superas una de las barreras psicológicas y técnicas más grandes de la profesión.
¡Felicidades! Con la finalización de este artículo, hemos cerrado íntegramente la Categoría 4 (Algoritmia y Lógica de Programación). Ya disponemos de 48 de los 60 artículos que componen la base de conocimientos tecnológicos del proyecto.