Internet es, sin lugar a dudas, la base de datos pública más gigantesca y actualizada de la historia humana. Cotizaciones de bolsa, catálogos de tiendas, ofertas de empleo, estadísticas deportivas y catálogos inmobiliarios se actualizan cada segundo. Sin embargo, toda esta información está diseñada para ser leída por ojos humanos a través de un navegador, no para ser procesada por máquinas.
Si necesitas comparar los precios de 500 ordenadores portátiles en tres tiendas distintas, o monitorizar si tu competencia ha bajado sus tarifas, hacerlo a mano copiando y pegando datos en un Excel te llevará días. Aquí es donde entra en juego el Web Scraping, la técnica de programación que permite a un script navegar por internet, leer el código fuente de las páginas y extraer la información estructurada que necesitas en cuestión de segundos.
En este artículo, descubriremos cómo Python se ha convertido en el lenguaje líder absoluto para el Web Scraping, cuáles son las librerías fundamentales que debes dominar y, lo más importante, cómo establecer límites éticos y legales para extraer datos sin tumbar servidores ajenos ni infringir la ley.
¿Qué es exactamente el Web Scraping?
El Web Scraping (raspadura web) es el proceso automatizado de recolección de datos de sitios web. Un programa de software, conocido comúnmente como bot o scraper, simula ser un usuario normal. Realiza una petición (HTTP Request) a una página web, descarga todo el código HTML subyacente y, a continuación, busca patrones específicos dentro de las etiquetas (como <h1 class="precio">) para extraer los datos útiles, descartando el diseño, los colores y los menús.
El valor comercial de esta técnica es incalculable. Empresas de todo el mundo utilizan el scraping para:
- Análisis de mercado y precios: Monitorizar a la competencia en tiempo real.
- Agregación de contenidos: Buscadores de vuelos u hoteles que recopilan datos de docenas de aerolíneas.
- Generación de Leads: Extraer directorios públicos de empresas para crear bases de datos de clientes potenciales.
- Entrenamiento de IA: Recolectar millones de artículos y textos públicos para entrenar Modelos de Lenguaje Grandes (LLMs).
Los 4 Mandamientos del Web Scraping Ético
Con un gran poder tecnológico viene una inmensa responsabilidad. Escribir un bucle while en Python que descargue páginas web 100 veces por segundo es muy fácil, pero al hacerlo, estás realizando un ataque de denegación de servicio (DDoS) involuntario contra el servidor del propietario de la web.
Para que tu scraping sea profesional, ético y legal, debes seguir estas cuatro reglas inquebrantables:
1. Respetarás el archivo robots.txt
Antes de rastrear cualquier sitio, debes revisar su archivo de políticas de rastreo (ej. [www.ejemplo.com/robots.txt](https://www.ejemplo.com/robots.txt)). Este archivo indica explícitamente a los bots qué carpetas pueden leer y cuáles están prohibidas. Si el administrador del sitio ha bloqueado la carpeta /precios/, un scraper ético no entrará ahí.
2. No saturarás el servidor (Rate Limiting)
Los humanos leemos despacio; las máquinas leen en milisegundos. Si envías 5.000 peticiones en un minuto, el servidor web gastará sus recursos en atender a tu bot en lugar de atender a clientes humanos reales. Debes forzar a tu código a hacer pausas (time.sleep()) entre cada petición para simular un comportamiento humano y ser respetuoso con el ancho de banda ajeno.
3. Extraerás únicamente datos públicos
El scraping ético se limita a la información que es de acceso público. Extraer datos que se encuentran detrás de un panel de inicio de sesión (Login), especialmente si contienen información personal de terceros (nombres, correos privados, datos bancarios), no solo es poco ético, sino que en la mayoría de jurisdicciones constituye un delito grave de violación de la privacidad (RGPD).
4. Te identificarás claramente
Por defecto, las librerías de programación se identifican como bots (ej. python-requests/2.25). Aunque muchos falsifican esta cabecera (User-Agent) para hacerse pasar por Chrome o Firefox, un scraper ético a menudo incluye un medio de contacto en la cabecera (ej. User-Agent: BotProyectoAcademico (contacto@miemail.com)), permitiendo al dueño de la web contactar si hay algún problema con el tráfico.
El Ecosistema Python: Herramientas del Oficio
Para extraer datos, necesitamos dos herramientas distintas: una para ir a buscar la página a internet (el mensajero) y otra para diseccionar el HTML y sacar los datos (el cirujano). El ecosistema de Python ofrece las mejores librerías del mercado para estas tareas.
1. Requests (El Mensajero)
Es la librería estándar de facto para hacer peticiones HTTP en Python. Con una sola línea de código (requests.get('[https://web.com](https://web.com)')), esta librería viaja al servidor, solicita la página y te devuelve todo el código fuente.
2. BeautifulSoup 4 (El Cirujano)
Una vez que Requests te ha traído un bloque gigantesco y caótico de HTML, BeautifulSoup lo procesa y lo convierte en un «Árbol» navegable. Te permite buscar elementos usando selectores lógicos muy similares a los de CSS. Puedes decirle: «Encuentra todas las etiquetas <div> que tengan la clase tarjeta-producto y extrae solo el texto de su interior».
3. Selenium o Playwright (La Artillería Pesada)
Hoy en día, muchas páginas modernas están construidas con frameworks de JavaScript (como React o Angular). Si usas Requests, solo obtendrás un HTML vacío, ya que el contenido se carga dinámicamente después de abrir la web. Para estas webs complejas, usamos Selenium. Esta herramienta abre un navegador web real e invisible en tu ordenador, espera a que el JavaScript cargue todos los datos y luego extrae la información simulando clics humanos.
Arquitectura de un Scraper Profesional y Ético
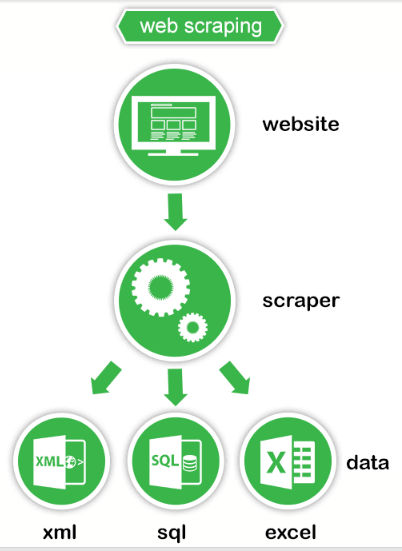
Vamos a poner la teoría en práctica construyendo un pequeño script que extrae títulos y enlaces de un blog tecnológico, aplicando los principios del código limpio (Clean Code) y el manejo de excepciones.
Primero, instalamos las dependencias necesarias en nuestro entorno virtual:
Bash
pip install requests beautifulsoup4
A continuación, estructuramos nuestro rastreador:
Python
import requests
from bs4 import BeautifulSoup
import time
import logging
import csv

# Configuración de auditoría para registrar cada paso
logging.basicConfig(level=logging.INFO, format='%(levelname)s: %(message)s')

def obtener_html(url):
    """Realiza la petición HTTP simulando un navegador estándar de forma ética."""
    cabeceras = {
        # Cabecera honesta que identifica al bot y un método de contacto
        'User-Agent': 'BotEstudioAnalitica (contacto@tuemail.com)'
    }

    try:
        # Añadimos un pequeño retraso para no saturar el servidor (Rate Limiting)
        time.sleep(2)
        respuesta = requests.get(url, headers=cabeceras, timeout=10)

        # Verifica si hay errores HTTP (ej. 404 No Encontrado o 500 Error de Servidor)
        respuesta.raise_for_status()
        return respuesta.text

    except requests.exceptions.RequestException as e:
        logging.error(f"Error al acceder a {url}: {e}")
        return None

def extraer_titulos(html):
    """Parsea el HTML y extrae los titulares usando BeautifulSoup."""
    if not html:
        return []

    sopa = BeautifulSoup(html, 'html.parser')
    articulos = []

    # Buscamos todas las etiquetas <h2> que tengan la clase 'titulo-post'
    for etiqueta in sopa.find_all('h2', class_='titulo-post'):
        # Extraemos el texto limpio, sin etiquetas HTML adicionales
        titulo = etiqueta.get_text(strip=True)
        # Extraemos el atributo 'href' del enlace (<a>)
        enlace = etiqueta.find('a')['href'] if etiqueta.find('a') else 'Sin enlace'

        articulos.append({'Titulo': titulo, 'Enlace': enlace})

    return articulos

if __name__ == '__main__':
    url_objetivo = 'https://ejemplo-blog-tecnologico.com/noticias'
    logging.info(f"Iniciando scraping ético en: {url_objetivo}")

    codigo_html = obtener_html(url_objetivo)
    datos_extraidos = extraer_titulos(codigo_html)

    # Exportamos los datos limpios a un archivo CSV
    if datos_extraidos:
        claves = datos_extraidos[0].keys()
        with open('titulares_tech.csv', 'w', newline='', encoding='utf-8') as archivo_salida:
            escritor = csv.DictWriter(archivo_salida, fieldnames=claves)
            escritor.writeheader()
            escritor.writerows(datos_extraidos)
        logging.info(f"Éxito: {len(datos_extraidos)} artículos guardados en CSV.")
Análisis del Código
Este script no es un simple juguete; está listo para producción. Incluye manejo de excepciones mediante raise_for_status() (si la página se cae, el programa no colapsará de forma impredecible). Además, el uso de la librería csv nos permite tener un archivo perfectamente estructurado que podemos abrir en Excel o cargar en una base de datos local como SQLite inmediatamente después de su ejecución.
Conclusión
El Web Scraping es un «superpoder» en el mundo de la programación. Te permite construir tus propias APIs cuando las empresas no las ofrecen y te da la capacidad de analizar datos a una escala masiva. Python, gracias a la elegancia de librerías como Requests y BeautifulSoup, ha democratizado esta tecnología, haciendo que extraer información sea cuestión de unas pocas docenas de líneas de código.
Sin embargo, tu reputación como desarrollador y la viabilidad de tus proyectos dependen de tu ética. Configura un User-Agent claro, respeta los tiempos de carga del servidor, nunca extraigas datos privados y convierte la inmensidad de internet en tu propia base de datos personal de forma responsable.